A mídia física está desaparecendo, os serviços por assinatura se multiplicam e o conceito de propriedade digital nunca esteve tão ameaçado. Afinal, o que realmente significa comprar um jogo, um filme ou um software?
3 curtidas
É por isso que não compro.
Quer meu dinheiro? – Ofereça algo que mereça.
4 curtidas
Já sabemos, pelo menos em parte, no que isso vai dar…
É por essas e outras que migrei tudo pra open source, pirataria e retro. Belo, ético e moral.
2 curtidas
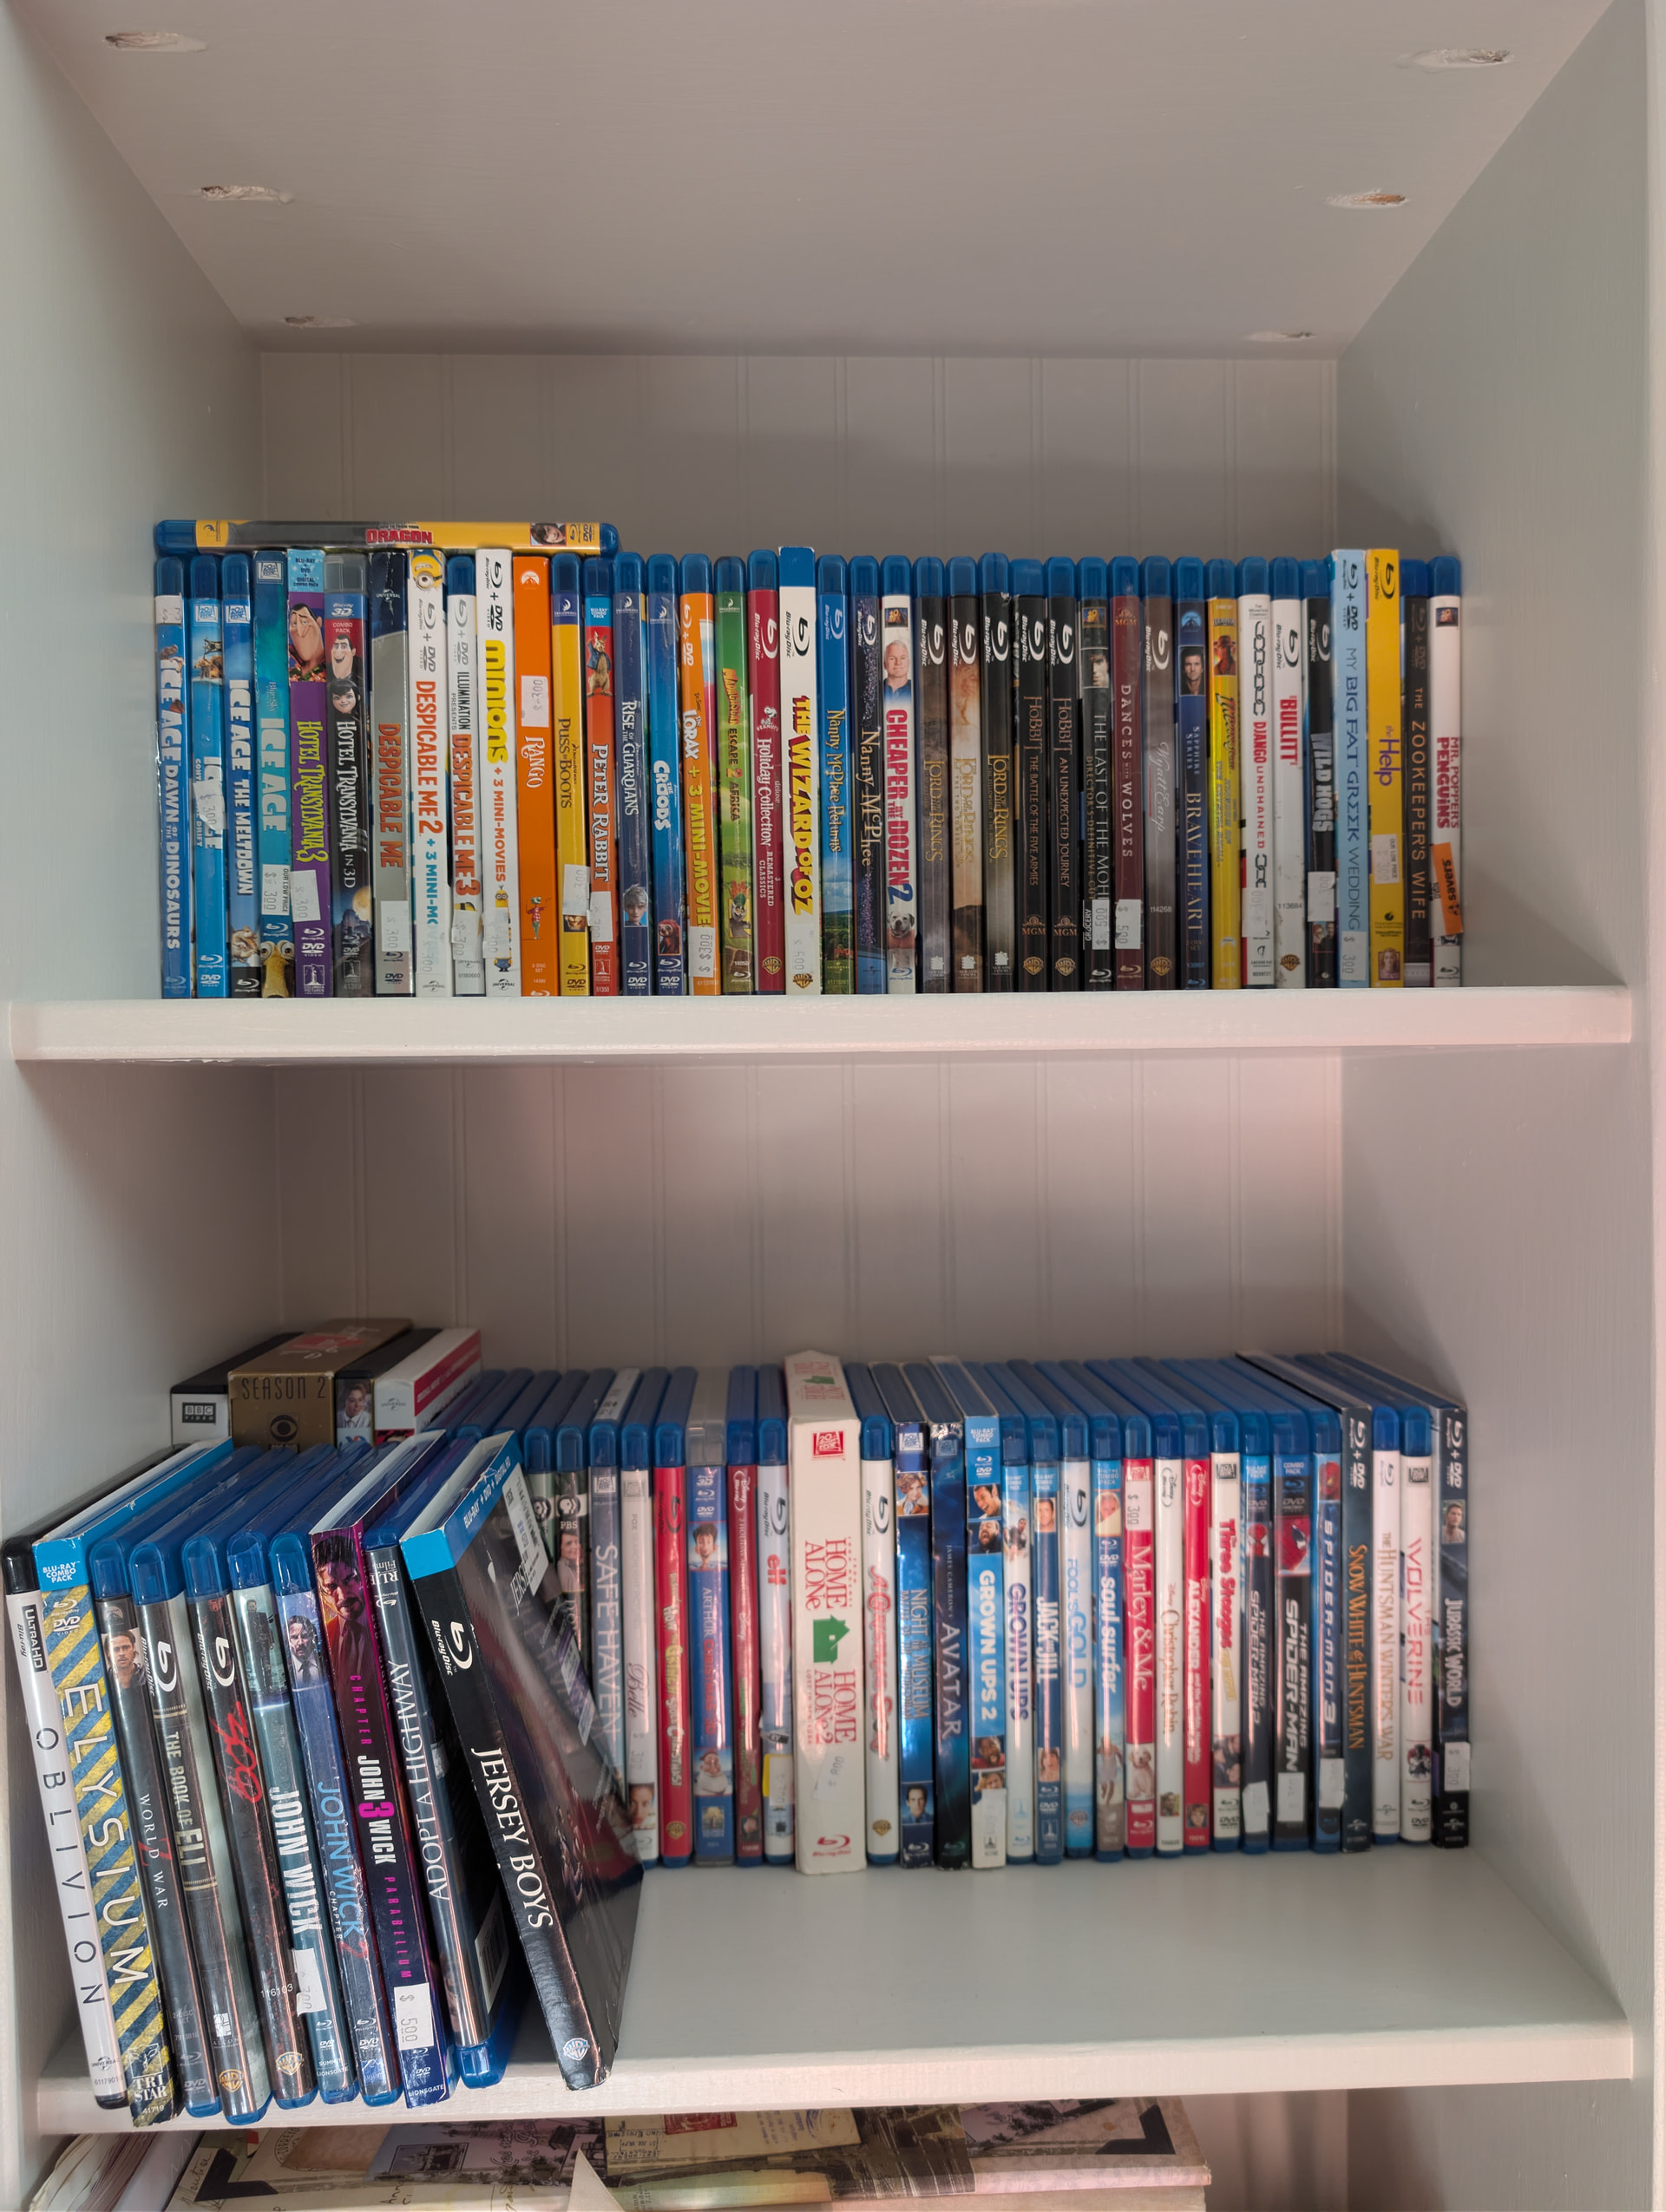
Cara, se eu tivesse espaço aqui em casa faria a mesma coisa, mas além do espaço morar em cidade de praia é uma desgraça pra colecionar qualquer coisa, tudo é destruído pela ação da maresia e umidade.
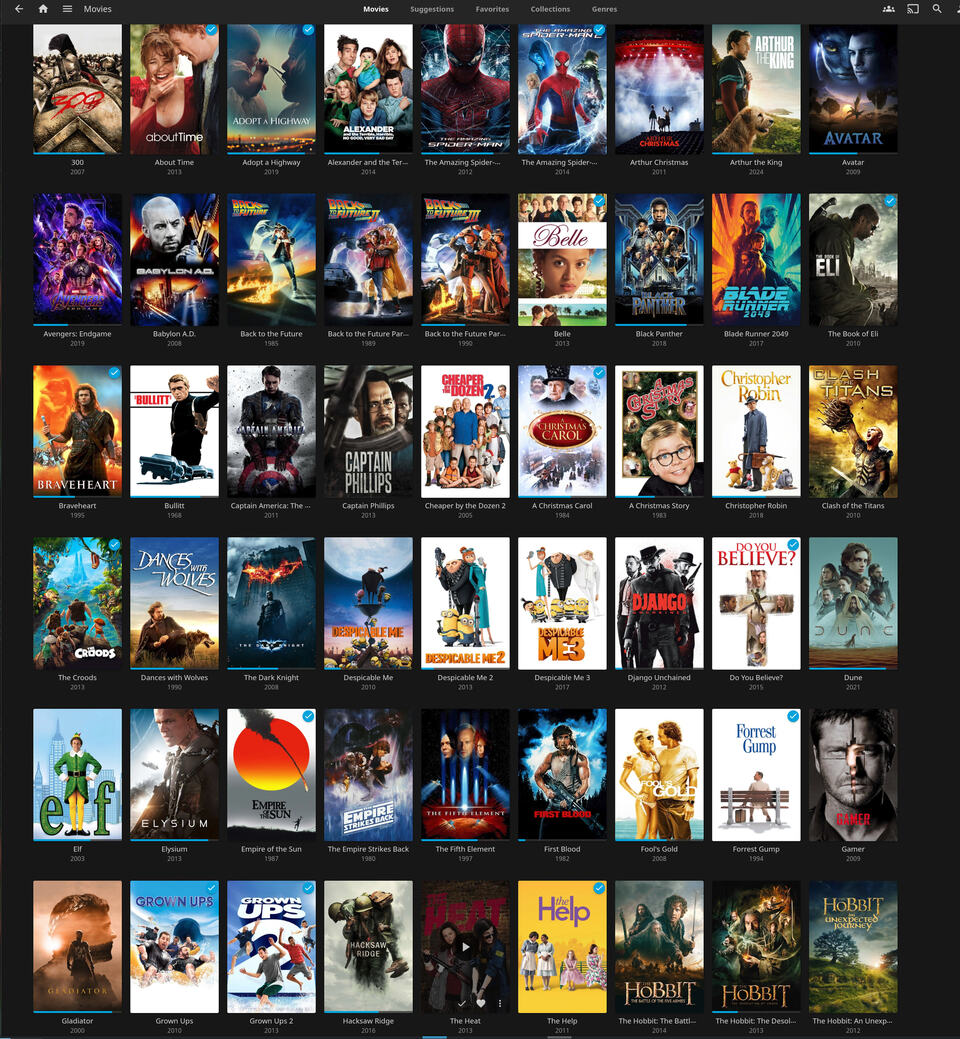
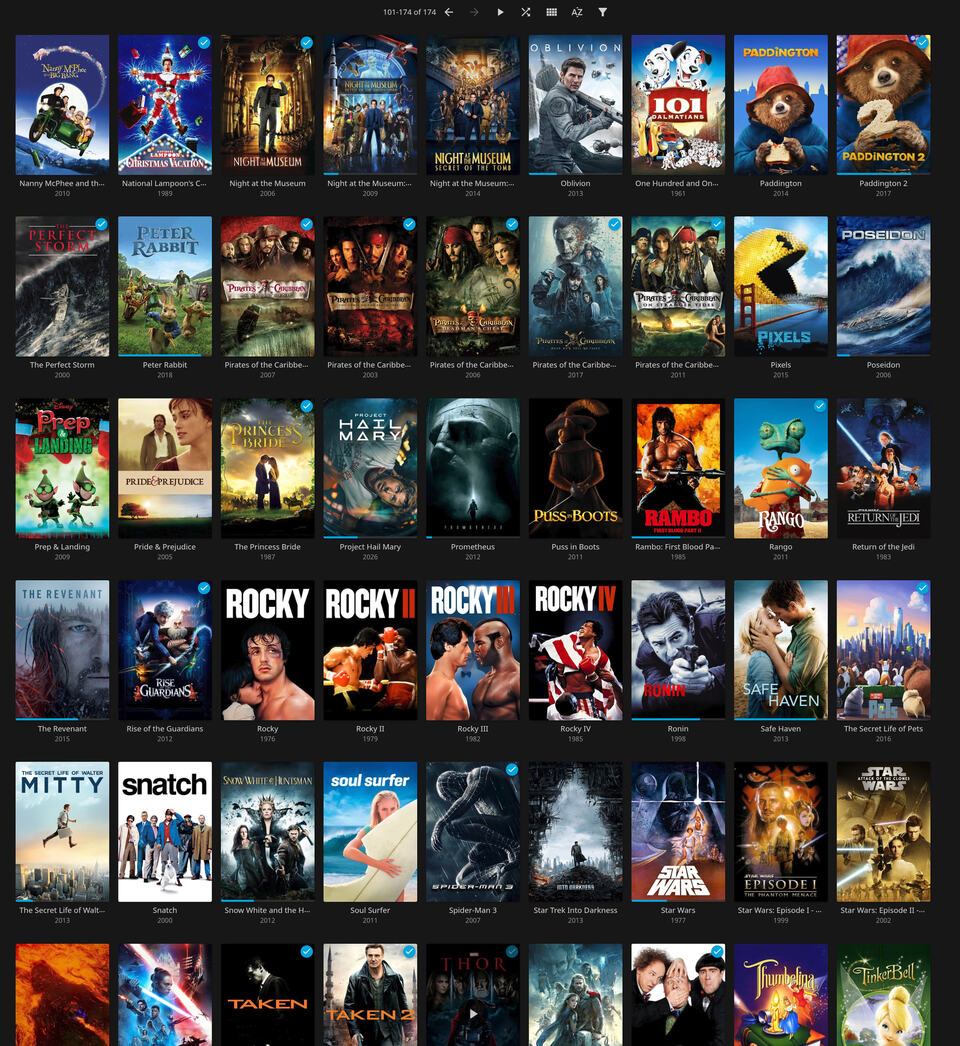
É só fazer backups todos já estão no meu servidor jelyfin e em outro hd encodado como av1 para video e opus para o audio ocupa o minimo de espaço possivel quase sem perder qualidade, por enquanto gastei pouco mais de 500gb de 12tb hds.
1 curtida
#!/usr/bin/env python3
import json
import os
import subprocess
import sys
import urllib.parse
import urllib.request
import re

# ============================================================
# CODEC QUALITY RANKING (higher = better, for auto-selection)
# ============================================================
CODEC_RANK = {
    "truehd": 10,
    "mlp": 10,  # Dolby TrueHD / Atmos
    "dts": 8,  # DTS-MA or DTS (ffprobe reports both as 'dts')
    "eac3": 6,  # Dolby Digital Plus / Atmos lossy
    "ac3": 4,  # Dolby Digital 5.1
    "aac": 3,
    "mp3": 2,
    "vorbis": 2,
    "opus": 2,
    "pcm_s24le": 9,
    "pcm_s16le": 7,  # Raw PCM (uncommon in remux but ranked high)
}

LANG_ALIASES = {
    "eng": ["eng", "en", "english"],
    "por": ["por", "pt", "ptbr", "pt-br", "portuguese", "portugues"],
}


def codec_rank(codec_name):
    return CODEC_RANK.get((codec_name or "").lower(), 1)


def match_lang(lang_tag, target):
    """Check if a language tag matches a target language group."""
    return (lang_tag or "").lower() in LANG_ALIASES.get(target, [target])


def get_output_dir():
    """Prompt for an output directory, remembering the last one used."""
    script_dir = os.path.dirname(os.path.abspath(__file__))
    cache_path = os.path.join(script_dir, ".last_output_dir")

    last_used = ""
    if os.path.exists(cache_path):
        with open(cache_path) as f:
            last_used = f.read().strip()

    prompt = "Enter output directory"
    prompt += f" [{last_used}]: " if last_used else ": "

    user_input = input(prompt).strip().strip('"').strip("'")
    output_dir = user_input or last_used

    if not output_dir:
        print("[ERROR] No output directory provided.")
        sys.exit(1)

    os.makedirs(output_dir, exist_ok=True)

    with open(cache_path, "w") as f:
        f.write(output_dir)

    return output_dir


def probe_streams(input_file, stream_type, entries):
    cmd = [
        "ffprobe",
        "-v",
        "error",
        "-analyzeduration",
        "2000M",
        "-probesize",
        "2000M",
        "-select_streams",
        stream_type,
        "-show_entries",
        entries,
        "-of",
        "json",
        input_file,
    ]
    try:
        out = subprocess.check_output(cmd, stderr=subprocess.DEVNULL).decode("utf-8")
        return json.loads(out).get("streams", [])
    except Exception as e:
        print(f"[WARNING] ffprobe failed for {stream_type}: {e}")
        return []


def auto_select_audio(audio_streams):
    eng_candidates = [s for s in audio_streams if match_lang(s.get("lang"), "eng")]
    por_candidates = [s for s in audio_streams if match_lang(s.get("lang"), "por")]

    def best(candidates):
        if not candidates:
            return None
        return max(candidates, key=lambda s: (codec_rank(s["codec"]), s["channels"]))

    selected = []
    best_eng = best(eng_candidates)
    best_por = best(por_candidates)

    if best_eng:
        selected.append(best_eng)
        print(
            f"  [AUTO] Best English : Stream #0:{best_eng['index']} "
            f'[{best_eng["channels"]}ch] ({best_eng["codec"]}) - "{best_eng["title"]}"'
        )
    else:
        print("  [AUTO] No English audio track found.")

    if best_por:
        selected.append(best_por)
        print(
            f"  [AUTO] Best PT-BR   : Stream #0:{best_por['index']} "
            f'[{best_por["channels"]}ch] ({best_por["codec"]}) - "{best_por["title"]}"'
        )
    else:
        print("  [AUTO] No Portuguese audio track found.")

    return selected


def auto_select_subtitles(sub_streams):
    skip_keywords = ["comment", "description", "director", "sdh+", "hearing impaired+"]
    selected = []
    seen_langs = {}

    def score_sub(s):
        title = (s.get("title") or "").lower()
        forced = 1 if "forced" in title else 0
        sdh = 1 if any(k in title for k in ["sdh", "hearing"]) else 0
        return (forced * 10) + sdh

    for target_lang in ["eng", "por"]:
        candidates = [
            s
            for s in sub_streams
            if match_lang(s.get("lang"), target_lang)
            and not any(k in (s.get("title") or "").lower() for k in skip_keywords)
        ]
        if not candidates:
            continue

        forced = [s for s in candidates if "forced" in (s.get("title") or "").lower()]
        full = [s for s in candidates if "forced" not in (s.get("title") or "").lower()]

        picks = []
        if forced:
            picks.append(max(forced, key=score_sub))
        if full:
            picks.append(max(full, key=score_sub))

        for s in picks:
            if s["index"] not in seen_langs:
                seen_langs[s["index"]] = True
                selected.append(s)
                print(
                    f"  [AUTO] Subtitle [{target_lang.upper()}]: Stream #0:{s['index']} "
                    f'({s["codec"]}) - "{s.get("title", "untitled")}"'
                )

    if not selected:
        print("  [AUTO] No matching subtitle tracks found.")

    return selected


def build_audio_args(selected_tracks):
    audio_args = []
    for i, track in enumerate(selected_tracks):
        ch = track["channels"]
        lang = track["lang"]
        idx = track["index"]
        is_surround = ch > 2
        lang_label = lang.upper()

        audio_args.extend(["-map", f"0:{idx}"])

        bitrate = "384k" if is_surround else "128k"
        ch_count = "6" if is_surround else "2"
        ch_label = "5.1" if is_surround else "2.0"
        audio_args.extend(
            [
                f"-c:a:{i}",
                "libopus",
                f"-b:a:{i}",
                bitrate,
                f"-ac:a:{i}",
                ch_count,
                f"-metadata:s:a:{i}",
                f"title={lang_label} Opus {ch_label}",
                f"-metadata:s:a:{i}",
                f"language={lang}",
            ]
        )
        print(f"  [AUDIO] Track {i + 1}: {lang_label} -> Opus {ch_label} @ {bitrate}")

    return audio_args


def process_movie(input_file, input_dir, tmdb_token):
    """Processes a single movie file."""
    input_base = os.path.splitext(os.path.basename(input_file))[0]

    # Clean MakeMKV naming artifacts (t001, t002, etc. case-insensitively)
    movie_title = re.sub(r'[_.]t\d+', '', input_base, flags=re.IGNORECASE)
    movie_title = " ".join(movie_title.replace(".", " ").replace("_", " ").split())

    # Give each movie its own output folder
    movie_dir = os.path.join(input_dir, movie_title)
    os.makedirs(movie_dir, exist_ok=True)

    cover_file = os.path.join(movie_dir, f"{movie_title}.jpg")
    output_file = os.path.join(movie_dir, f"{movie_title}.mkv")

    print("\n" + "=" * 60)
    print(f" PROCESSING: {movie_title}")
    print(f" Input File: {input_file}")
    print(f" Output Dir: {movie_dir}")
    print("=" * 60)

    # Skip if output already exists to prevent losing progress on huge batches
    if os.path.exists(output_file):
        print(f"[SKIP] Output file already exists: {output_file}")
        return

    # ============================================================
    # TMDB LOOKUP
    # ============================================================
    release_date = ""
    overview = ""

    if tmdb_token and tmdb_token != "PASTE_YOUR_LONG_ACCESS_TOKEN_HERE":
        print(f"\nSearching TMDb for: '{movie_title}'...")
        try:
            url_title = urllib.parse.quote(movie_title)
            url = (
                f"https://api.themoviedb.org/3/search/movie"
                f"?query={url_title}&include_adult=false&language=en-US&page=1"
            )
            req = urllib.request.Request(url)
            req.add_header("Authorization", f"Bearer {tmdb_token}")
            req.add_header("accept", "application/json")
            with urllib.request.urlopen(req, timeout=5) as response:
                data = json.loads(response.read().decode())
                if data.get("results"):
                    result = data["results"][0]
                    poster_path = result.get("poster_path")
                    release_date = result.get("release_date", "")
                    overview = result.get("overview", "")
                    if not os.path.exists(cover_file) and poster_path:
                        print("  Found cover art — downloading poster...")
                        poster_url = f"https://image.tmdb.org/t/p/w600_and_h900_bestv2{poster_path}"
                        urllib.request.urlretrieve(poster_url, cover_file)
                    if release_date:
                        print(f"  Release Date : {release_date}")
        except Exception as e:
            print(f"  [WARNING] TMDb lookup failed ({e}).")

    # ============================================================
    # PROBE AUDIO
    # ============================================================
    raw_audio = probe_streams(
        input_file, "a", "stream=index,codec_name,channels:stream_tags=language,title"
    )
    if not raw_audio:
        print(f"[ERROR] No audio tracks found for {movie_title}. Skipping.")
        return

    audio_streams = []
    for s in raw_audio:
        tags = s.get("tags", {})
        lang = (tags.get("language") or tags.get("LANGUAGE") or "unknown").lower()
        title = tags.get("title") or tags.get("TITLE") or f"Track {s['index']}"
        entry = {
            "index": str(s["index"]),
            "codec": s.get("codec_name", "unknown"),
            "channels": int(s.get("channels") or 2),
            "lang": lang,
            "title": title,
        }
        audio_streams.append(entry)

    selected_audio = auto_select_audio(audio_streams)
    if not selected_audio:
        print(f"[ERROR] No usable audio tracks selected for {movie_title}. Skipping.")
        return

    # ============================================================
    # PROBE SUBTITLES
    # ============================================================
    raw_subs = probe_streams(
        input_file, "s", "stream=index,codec_name:stream_tags=language,title"
    )
    sub_streams = []
    if raw_subs:
        for s in raw_subs:
            tags = s.get("tags", {})
            sub_streams.append(
                {
                    "index": str(s["index"]),
                    "codec": s.get("codec_name", "unknown"),
                    "lang": (tags.get("language") or "unknown").lower(),
                    "title": tags.get("title") or "",
                }
            )
        selected_subs = auto_select_subtitles(sub_streams)
    else:
        selected_subs = []

    # ============================================================
    # BUILD FFMPEG COMMAND
    # ============================================================
    cmd = [
        "ffmpeg",
        "-hide_banner",
        "-probesize",
        "2G",
        "-analyzeduration",
        "2G",
        "-i",
        input_file,
    ]

    if os.path.exists(cover_file):
        cmd.extend(
            [
                "-attach",
                cover_file,
                "-metadata:s:t:0",
                "filename=cover.jpg",
                "-metadata:s:t:0",
                "mimetype=image/jpeg",
            ]
        )

    cmd.extend(["-map", "0:v:0"])

    color_info = probe_streams(input_file, "v:0", "stream=color_transfer")
    color_transfer = color_info[0].get("color_transfer", "") if color_info else ""

    svt_params = "tune=0"
    if color_transfer == "smpte2084":
        svt_params += ":enable-hdr=1:color-primaries=9:transfer-characteristics=16:matrix-coefficients=9"

    cmd.extend(
        [
            "-c:v",
            "libsvtav1",
            "-preset",
            "4",
            "-crf",
            "18",
            "-g",
            "240",
            "-pix_fmt",
            "yuv420p10le",
            "-svtav1-params",
            svt_params,
        ]
    )

    audio_args = build_audio_args(selected_audio)
    cmd.extend(audio_args)

    if selected_subs:
        for s in selected_subs:
            cmd.extend(["-map", f"0:{s['index']}"])
        cmd.extend(["-c:s", "copy"])
    else:
        cmd.extend(["-map", "0:s?", "-c:s", "copy"])

    cmd.extend(
        [
            "-map",
            "0:t?",
            "-map_metadata",
            "0",
            "-map_chapters",
            "0",
            "-metadata",
            f"title={movie_title}",
            "-metadata",
            f"DATE_RELEASED={release_date}",
            "-metadata",
            f"DESCRIPTION={overview}",
            "-metadata",
            "COMMENT=Encoded via SVT-AV1 Software",
            "-metadata:s:v:0",
            "language=eng",
            "-ignore_unknown",
            output_file,
        ]
    )

    try:
        subprocess.run(cmd, check=True)
        print(f"[SUCCESS] Saved: {output_file}\n")
    except subprocess.CalledProcessError as e:
        print(
            f"[ERROR] FFmpeg failed on {movie_title} with exit code: {e.returncode}\n"
        )


def main():
    if len(sys.argv) < 2:
        print("Error: Please drag and drop one or more video files onto this script.")
        sys.exit(1)

    # Get list of all dropped files
    input_files = sys.argv[1:]

    # Ask for output directory (remembers last-used path)
    target_output_dir = get_output_dir()

    # Optional TMDb configuration
    tmdb_token = ""
    print(f"Batch mode initialized. Found {len(input_files)} file(s) to process.")
    print(f"All outputs will land in: {target_output_dir}\n")

    for index, file_path in enumerate(input_files, start=1):
        print(f"Progress: Movie {index} of {len(input_files)}")
        if not os.path.exists(file_path):
            print(f"[ERROR] File does not exist, skipping: {file_path}")
            continue
        process_movie(file_path, target_output_dir, tmdb_token)

    print("\n" + "=" * 60)
    print(" ALL BATCH JOBS COMPLETE!")
    print("=" * 60)


if __name__ == "__main__":
    main()
Estou automatizando o processo, tirando a parte de ripar o Blu-ray, que só funciona um por um por limite do meu hardware. A parte de reencode fiz um script em batch, vibe coded no cloud  . Na linha 423 coloco a chave da API do https://www.themoviedb.org/, assim ele baixa a capinha e os metadados do filme e encoda junto ao filme. Com esse script, muitos raws de Blu-ray de 30 GB caem para 3 GB.
Como funciona: Rodo o script e jogo todos os arquivos MKV de uma vez no terminal, o script pede onde quero colocar os novos arquivos recodados, passo o path e ele cria uma pasta nova com a capa do filme e reencoda em sequência, eu só espero.
Isso só para bluray 1080p para 4k uso um script diferente vou unificar os dois um dia.
2 curtidas
Sigo o mesmo princípio: – Melhor ter guardado aqui, do que depender de conexão, nuvem etc.
Mas me limito a 5,5 mil músicas em MP3 e alguns vídeos baixados (em geral, com baixa, péssima resolução)… mas cada vez baixo menos vídeos. – Só, os “muito essenciais”.
Vídeos não-importantes, melhor ver no Youtube, mesmo – e GMail… bom, essa é minha dependência. Não vou ficar baixando 15 mil emails.
3 curtidas
Quem abdicar completamente de seus livros, filmes, discos, jogos, mídia física em geral, ou arquivos locais, em prol de uma propalada praticidade, confiando em nuvem, streaming e afins, vai se arrepender amargamente no futuro quando não tiver acesso à uma série de conteúdo. Até gente das novas gerações está percebendo isso, tanto que repentinamente, as vendas de DAPs (MP3 players) subiram significativamente.
2 curtidas
Eu guardei por uma decada minha biblioteca do ipod classic, só porque tinha espaço num hd e muita memória afetiva.
Hoje em dia dou graças a Deus, porque está ficando impossível ouvir música por streaming. Albuns somem o tempo todo do catálogo, o algoritmo irrita e as plataformas estão sendo inundadas de artistas falsos feitos por IA.
O que já foi uma grande comodidade para acompanhar os seus artistas favoritos virou um dos piores serviços do mercado, na minha opinião.
3 curtidas
Eu nem acho que o sistema de assinatura seja tão ruim. Pra mim, o pior desses serviços é que você coloca algo que vc quer ouvir e dali um tempo já tá passando algo que você nem queria (ou começando o próximo episódio da série automaticamente). É o algoritmo escolhendo por você para martelar o que ele quer, ou te manter na plataforma o maior tempo possível.
Sou um tanto saudosista da época que colocava um cd pra tocar e quando chegava no final, o som parava e você tinha que ter alguma ação, seja para colocar outro cd, ou mesmo para aproveitar e ir andar de bicicleta. Era tipo um ‘pomodoro’ de 1h ±. Também da época que a série tinha um episódio por dia, com hora marcada na TV, a gente via o do dia e outros só amanhã.
2 curtidas
A pergunta já tem resposta na linha do tempo: as VIDEO LOCADORAS do bairro da década passada onde também se pagava para jogar e ver filmes, negocio brasileiro baseado no negocio da NETFLIX dos EUA. E logo veio Blockbuster na Americanas até o NETFLIX inundar o mundo com o streaming. A internet só modelou/facilitou o sistema americano de direitos autorais ou royalties que exige a arrecadação previsível, direcionando todas as veias arrecadatórias do mundo ao mercado americano. A União Europeia (UE) atualmente é o contra-peso neste cenário.
Aguardem os próximos capítulos da novela Negócios de Software.
Datacenters e datacenters.
E inventaram o Windows 365 Cloud PC, assinatura só de uso. A licença perpétua está desaparecendo.
A posse de algo físico é rumar ao hardware com baixa obsolecência e software livre.
É bem isso. A rotina atarefada e usar o combo jellyfin + navidrome (tava usando o lyrion server e acabei migrando) aqui em casa me deixaram mais ou menos como era antigamente. Eu tenho pouco tempo e pouco espaço em disco para armazenar tranqueira, então acabo baixando uma temporada e vou vendo a conta gotas durante umas semanas. Como não consigo baixar trocentas ao mesmo tempo eu me obrigo a terminar aquela pra deletar e baixar a próxima temporada. Tô faz mais de um mês assistindo halt and catch fire e ainda não cheguei nem no final da primeira temporada hahaha. Assistir filmes é muito mais intencional também, eu dou uma pesquisada, baixo, marco um dia que vai dá pra ver e assisto. É uma experiência muito melhor. Em relação as músicas é basicamente a mesma coisa, compro bastante album quando posso no bandcamp e baixo eles em FLAC pro meu tocadorzin chinês ou deixo no server navidrome. Quando dá sento num canto, faço um café ou pego uma gelada e sento pra ouvir o som, quase como colocar um CD ou vinil antigamente.
Outra coisa que isso daí me ajudou bastante foi com minhas filhas, eu baixo os filmes e desenhos e deixo no jellyfin numa conta bem limitada pra elas com limite de tempo, assim não ficam o dia inteiro naquelas porcarias do youtube/netflix/etc. **** como tem desenho lixo nessas plataformas. Como o acervo é limitado elas assistem ali o que tão afim, cansam e vão brincar de outra coisa. Se deixa nesse universo infinito de algoritmo dá até briga pra tirar da tela. Retrogame elas curtem bastante também, o que mais rola aqui em casa é emulador de console velho, na minha modesta opinião são ordens de magnitude superior a essas tranqueiras mobile que a garotada joga hoje em dia. Deusolivre dar um celular na mão de criança. Sem contar que esses jogos antigos são dificeis pra *****, a criançada cria uma resiliência boa jogando isso daí hehe.
3 curtidas
Mesmo adeus cracks que muitas fezes causavam virus ou spyware, e tava uma data de horas a corrigir … !
Bendita a hora que mudei para o Linux !
xii tantos backups … !
Faz-me lembrar quando saía uma versão nova de uma distro, eu gravava para um Live CD / DVD, e ainda tenho uma boa coleção desses CDs / DVDs 
Eu tmb tinha uns DVDs do ubuntu 10.04 até pouco tempo  .
Mas o Jellyfin transforma meus backups em uma netflix pessoal que nunca expira e com melhor qualidade compro a maioria dos blurays usados fica bem mais barato e um backup fisico por muitos anos.

2 curtidas
Mas isso fica guardado no disco ou na cloud ?
O jellyfin é um servidor linux, no meu caso to rodando ele no proxmox juntamente com Nginx Proxy Manager para poder acessar de qualquer lugar fora de casa via streaming.
Então os filmes estão em um HD que configurei para o Jellyfin server na minha casa mas posso acessar de qualquer lugar inclusive compartilhar meus filmes com a familia quase como um cloude que mora na minha casa.
1 curtida