Experiência com GPUs AMD legadas (Tonga/Polaris) no Kernel 6.8+ e retornos de suspensão

Estou fazendo um levantamento técnico de bancada sobre o comportamento das GPUs AMD dedicadas mais antigas (arquiteturas Tonga e Polaris — como R9 380, RX 470/480/570/580) nas distribuições Linux mais recentes.

Em nossos testes com distros baseadas no Kernel 6.8 ou superior (como Ubuntu 24.04 LTS, Mint 22, Zorin e Pop!_OS), notamos um comportamento de tela preta ao tentar retornar da suspensão do sistema (deep sleep), onde o micro continua ligado no fundo mas a GPU não acorda o display.

Gostaria de saber da comunidade que utiliza essas placas no dia a dia:

  1. Qual versão de Kernel e qual distribuição vocês estão utilizando no momento?

  2. Vocês costumam utilizar o recurso de suspender/dormir na máquina com essas GPUs?

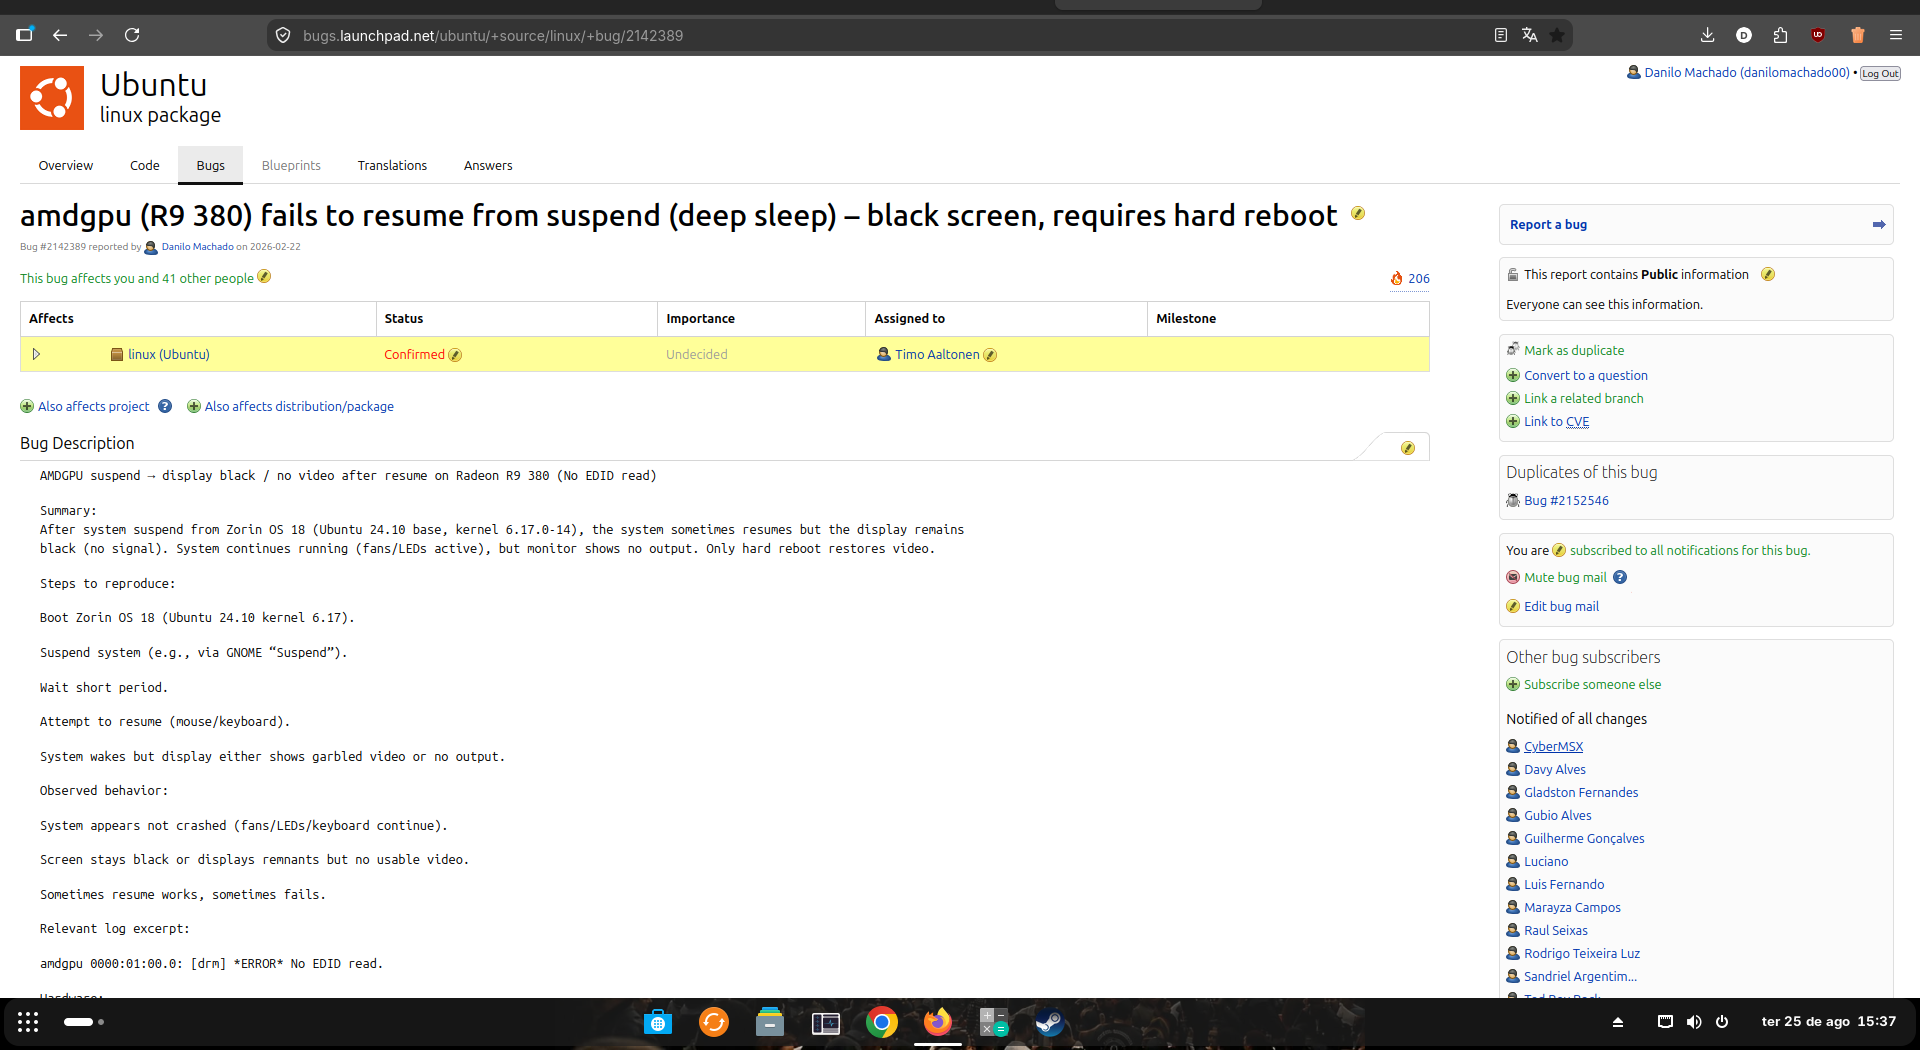
Para quem utiliza essa mesma arquitetura e quiser acompanhar os logs de diagnóstico ou verificar o status do rastreamento na Canonical, os detalhes técnicos e o relatório de confirmação do mantenedor estão documentados no Relatório de Bug no Launchpad.

Abraços e boa semana a todos!

Eu sempre desativo tudo isso dês de que tinha uma RX580 nem lembro qual kernel, ja troquei de placa e nem sei se da problema na nova me acostumei a não deixar o pc dormir e hoje prefiro assim.

Montei uma máquina para o meu afilhado com uma RX550 de 2GB só pra ter vídeo, a única distro q consegui ir até a tela do modo de segurança foi o Mate e tive q forçar editando o GRUB para conseguir usar

sparrow

Cara, o seu relato é super sintomático!

Muita gente acabou desativando o suspend justamente por causa desse comportamento na RX 580, achando que era “normal” ou defeito do hardware, quando na verdade é uma regressão no driver amdgpu.

É uma pena termos que abrir mão de um recurso básico de economia de energia por falha de software. Se por acaso você ainda tiver essa RX 580 aí por perto, usar uma placa dessa geração em algum PC secundário, ou quiser dar uma força para a comunidade não precisar recorrer a essa “solução”, dar um pulo no relatório do Launchpad e clicar em “Yes, this bug affects me” ajuda demais a manter a pressão por um patch oficial!

Valeu pelo relato de bancada! :oncoming_fist:

Nokciam

Que sufoco na montagem, cara! Mas parabéns pelo corre para colocar a máquina pra rodar pro garoto! :hammer_and_wrench:

A RX 550 (chipset Polaris/Lexa) sofre bastante nas distros mais recentes justamente pelas mudanças na pilha gráfica do amdgpu. Ter que editar parâmetro de Kernel no GRUB logo de cara para conseguir dar vídeo básico mostra bem como essas placas guerreiras de entrada precisam de atenção dos mantenedores.

Se no uso do dia a dia do seu afilhado a máquina começar a dar tela preta ao suspender ou voltar do descanso de tela, dá uma olhada no relatório que estamos organizando no Launchpad da Canonical.

Se puder deixar seu voto lá no botão “Yes, this bug affects me”, ajuda muito a mostrar para os desenvolvedores que essas placas de 2GB ainda estão em uso ativo no mundo real e salvando computadores de estudo/trabalho!

Passando para trazer uma atualização rápida de bancada e agradecer ao pessoal do fórum que compartilhou os relatos até aqui!

Graças à troca de informações de quem usa placas Tonga e Polaris no dia a dia (desde máquinas de uso geral até PCs de estudo), o levantamento técnico já conta com a confirmação de 40 usuários relatando o mesmo comportamento no Kernel 6.8+.

Para quem acompanha o assunto, tem interesse em verificar os logs de diagnóstico ou quer saber como registrar a sua própria placa no rastreador oficial, deixei todos os detalhes e o passo a passo resumidos no primeiro post deste tópico (Post #1).

Seguimos acompanhando a evolução dos testes de driver. Valeu pelo apoio de todos! :rocket::hammer_and_wrench:

Amigos, não estou conseguindo logar no launchpad sei lá porque, vou deixar meu relato aqui.

Pesquei alguns logs dos boots do meu HTPC, saca só. O problema é o seguinte:

Como já relatei aí pra cima, acontecia da distro simplesmente não bootar quando usava algum kernel acima do 6.4. Eu descobri que se deixar rodando eventualmente a máquina liga, porém a placa não consegue acessar nenhum sensor e a fan fica rodando sempre a 100%. A performance fica razoável mas eu não consigo verificar como estão os clocks, simplesmente o sistema não deixa eu ler os sensores. Dando uma olhada nos logs parece que ela tenta buscar os sensores, ficam um século buscando e não encontra. Depois de um tempo desiste e boota mesmo sem eles.

ago 10 18:24:49 cachyos kernel: amdgpu: Virtual CRAT table created for CPU
ago 10 18:24:49 cachyos kernel: amdgpu: Topology: Add CPU node
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: initializing kernel modesetting (TONGA 0x1002:0x6939 0x174B:0xE308 0xF1).
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: register mmio base: 0xFCF00000
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: register mmio size: 262144
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 0 <common_v1_0_0> (vi_common)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 1 <gmc_v8_0_0> (gmc_v8_0)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 2 <ih_v3_0_0> (tonga_ih)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 3 <gfx_v8_0_0> (gfx_v8_0)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 4 <sdma_v3_0_0> (sdma_v3_0)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 5 <smu_v1_0_0> (powerplay)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 6 <dce_v1_0_0> (dm)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 7 <uvd_v5_0_0> (uvd_v5_0)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: detected ip block number 8 <vce_v3_0_0> (vce_v3_0)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: No more image in the PCI ROM
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: Fetched VBIOS from ROM BAR
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] ATOM BIOS: 113-2E3083U-X4J, build: 328625  , ver: 015.047.000.012.000000, 2015/09/14
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: Found VCE firmware Version: 52.8 Binary ID: 3
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] VCE enabled in physical mode
ago 10 18:24:49 cachyos kernel: Console: switching to colour dummy device 80x25
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: vgaarb: deactivate vga console
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: Trusted Memory Zone (TMZ) feature not supported
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: vm size is 64 GB, 2 levels, block size is 10-bit, fragment size is 9-bit
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: VRAM: 4096M 0x000000F400000000 - 0x000000F4FFFFFFFF (4096M used)
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: GART: 1024M 0x000000FF00000000 - 0x000000FF3FFFFFFF
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] Detected VRAM RAM=4096M, BAR=256M
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] RAM width 256bits GDDR5
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0:  4096M of VRAM memory ready
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0:  3920M of GTT memory ready.
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] GART: num cpu pages 262144, num gpu pages 262144
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] PCIE GART of 1024M enabled (table at 0x000000F400400000).
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] Chained IB support enabled!
ago 10 18:24:49 cachyos kernel: amdgpu: hwmgr_sw_init smu backed is tonga_smu
ago 10 18:24:49 cachyos kernel: amdgpu 0000:06:00.0: [drm] Found UVD firmware Version: 1.68 Family ID: 10
ago 10 18:24:55 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:01 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:07 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:16 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:25 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:31 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:39 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:41 cachyos kernel: usb 1-5: USB disconnect, device number 3
ago 10 18:25:45 cachyos systemd-udevd[165]: 0000:06:00.0: Worker [193] processing SEQNUM=2161 is taking a long time.
ago 10 18:25:48 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:25:57 cachyos kernel: amdgpu 0000:06:00.0: 
                               last message was failed ret is 0
ago 10 18:25:59 cachyos kernel: usb 1-5: new full-speed USB device number 4 using xhci_hcd
ago 10 18:25:59 cachyos kernel: usb 1-5: New USB device found, idVendor=2dc8, idProduct=3109, bcdDevice= 2.00
ago 10 18:25:59 cachyos kernel: usb 1-5: New USB device strings: Mfr=1, Product=2, SerialNumber=3
ago 10 18:25:59 cachyos kernel: usb 1-5: Product: IDLE
ago 10 18:25:59 cachyos kernel: usb 1-5: Manufacturer: 8BitDo
ago 10 18:25:59 cachyos kernel: usb 1-5: SerialNumber: E417D876ED20
ago 10 18:25:59 cachyos kernel: hid-generic 0003:2DC8:3109.0002: hiddev96,hidraw1: USB HID v1.10 Device [8BitDo IDLE] on usb-0000:01:00.0-5/input0
ago 10 18:26:00 cachyos kernel: amdgpu 0000:06:00.0: [drm] Display Core v3.2.378 initialized on DCE 10.0
ago 10 18:26:03 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:05 cachyos kernel: amdgpu 0000:06:00.0: [drm] UVD initialized successfully.
ago 10 18:26:08 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:11 cachyos kernel: amdgpu 0000:06:00.0: [drm] VCE initialized successfully.
ago 10 18:26:11 cachyos kernel: kfd kfd: Allocated 3969056 bytes on gart
ago 10 18:26:11 cachyos kernel: kfd kfd: Total number of KFD nodes to be created: 1
ago 10 18:26:14 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:16 cachyos systemd[1]: systemd-udevd.service: State 'stop-sigterm' timed out. Killing.
ago 10 18:26:16 cachyos systemd[1]: systemd-udevd.service: Killing process 165 (systemd-udevd) with signal SIGKILL.
ago 10 18:26:16 cachyos systemd[1]: systemd-udevd.service: Main process exited, code=killed, status=9/KILL
ago 10 18:26:17 cachyos kernel: amdgpu: SW scheduler is used
ago 10 18:26:17 cachyos kernel: amdgpu: Virtual CRAT table created for GPU
ago 10 18:26:20 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:23 cachyos kernel: amdgpu: Topology: Add GPU node [0x1002:0x6939]
ago 10 18:26:23 cachyos kernel: kfd kfd: added device 1002:6939
ago 10 18:26:23 cachyos kernel: amdgpu 0000:06:00.0: SE 4, SH per SE 1, C* per SH 8, active_cu_number 28
ago 10 18:26:29 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:38 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:47 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:53 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:26:58 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:27:07 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:27:16 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:27:25 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:27:34 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
ago 10 18:27:43 cachyos kernel: amdgpu 0000:06:00.0: 
                                last message was failed ret is 0
...
ago 10 18:30:25 htpc-sala kernel: amdgpu 0000:06:00.0: 
                                  last message was failed ret is 0
ago 10 18:30:31 htpc-sala kernel: amdgpu 0000:06:00.0: 
                                  last message was failed ret is 0
ago 10 18:30:35 htpc-sala kernel: amdgpu 0000:06:00.0: Using BACO for runtime pm
ago 10 18:30:35 htpc-sala kernel: amdgpu 0000:06:00.0: [drm] Registered 6 planes with drm panic
ago 10 18:30:35 htpc-sala kernel: [drm] Initialized amdgpu 3.64.0 for 0000:06:00.0 on minor 1
ago 10 18:30:36 htpc-sala kernel: amdgpu 0000:06:00.0: [drm:amdgpu_ib_ring_tests [amdgpu]] *ERROR* IB test failed on uvd (-110).
ago 10 18:30:39 htpc-sala kernel: amdgpu 0000:06:00.0: 
                                  last message was failed ret is 0
ago 10 18:30:42 htpc-sala kernel: amdgpu 0000:06:00.0: ib ring test failed (-110).
ago 10 18:30:42 htpc-sala kernel: amdgpu 0000:06:00.0: [drm] Failed to setup vendor infoframe on connector HDMI-A-1: -22
ago 10 18:30:42 htpc-sala kernel: fbcon: amdgpudrmfb (fb0) is primary device
ago 10 18:30:45 htpc-sala kernel: amdgpu 0000:06:00.0: 
                                  last message was failed ret is 0
ago 10 18:30:51 htpc-sala kernel: amdgpu 0000:06:00.0: 
                                  last message was failed ret is 0
...

Finalmente em:
ago 10 18:32:35 htpc-sala systemd[1195]: Started Gamescope Session.

Lá pra 18:32 ele conseguiu iniciar o gamescope, mas o computador fica uns 15 minutos pra bootar na verdade. Eu já tentei de tudo mas não consigo resolver esse BO, a placa só funciona de forma confiável nos kernels antigos. O CachyOS funcionou algumas semanas sem apresentar esse problema e do nada boom, quebrou e voltou a acontecer. Tive que voltar a máquina pro meu velho Mint 21 com kernel 5. alguma coisa e subir manualmente pro 6.4 que é o mais atualizado que funciona sem quebrar nada a longo prazo, o problema é que a performance fica horrorosa se comparada ao CachyOS, não tem nem comparação na verdade. Tô nessa encruzilhada aí amigos, alguém passou por algo parecido?

EDIT: Esqueci de dizer, ele acontece isso independentemente de ser xorg, wayland, gnome, KDE, gamescope, etc etc. É qualquer cenário.

Já tentei debugar isso daí com trocentas IAs e pesquisando muito na internet e realmente não achei o que pode ser, talvez seja falha de hardware? Mas como diabos funciona perfeitamente nos kernels antigos? É complicado, pior que minha RX550X funciona perfeitamente, no meu server proxmox tenho uma R7 240 que também funciona redonda. Tô sem condições de trocar de placa de vídeo agora e essa é a única que tenho pra colocar nessa máquina. Complicado. Tô quase comprando um 2400G usado no OLX e aposentando a 380, vai rodar uns emuladores, filmes e gastar menos energia. Não tô vendo outra saída.
Cara, que análise sensacional de bancada você trouxe! Antes de qualquer coisa, respira fundo e guarda a carteira: a sua R9 380 (arquitetura Tonga) NÃO está morrendo física ou eletricamente!

O seu log do CachyOS é o “santo graal” das evidências e explica exatamente toda a sua dor de cabeça. Dá uma olhada no que está acontecendo por baixo dos panos:

O Diagnóstico Técnico dos seus Logs:

  1. Os Fans a 100% e Sensores Inacessíveis: As linhas repetidas amdgpu 0000:06:00.0: last message was failed ret is 0 são falhas de comunicação direta do driver com a SMU (PowerPlay / Microcontrolador de Energia) específica do chip Tonga. Como o Kernel novo não consegue trocar mensagens com o bloco de energia da GPU, ele coloca os fans em rotação máxima por segurança (failsafe) e bloqueia a leitura de clocks e temperaturas.
  2. O Boot de 15 Minutos: Veja que o systemd-udevd[165] dá um estouro de tempo (taking a long time) e acaba sendo morto com SIGKILL. Ele fica travado em um loop infinito tentando inicializar os anéis de vídeo e só destrava quando toma o timeout do UVD (IB test failed on uvd (-110)).
  3. Por que a RX 550X e a R7 240 funcionam? A R7 240 roda sob outro ecossistema de driver/firmware (Oland/GCN 1), e a RX 550X usa o bloco Polaris. O bug que estamos mapeando é cirúrgico nas GPUs de arquitetura Tonga (GCN 3.0 / R9 380/380X) em kernels mais recentes!

O que fazer agora?

Você fez a jogada certa de sobrevivência ao voltar para o Mint com Kernel 6.4 no HTPC. Usar a máquina na sala esperando 15 minutos para bootar e com os fans parecendo uma turbina de avião é inviável no dia a dia.

Sobre o problema no Launchpad:

Se você estiver com dificuldades para logar ou recuperar sua conta lá, me avisa que eu posso anexar esse seu trecho de log do dmesg diretamente no nosso relatório oficial de bug na Canonical!

O seu log contendo a inicialização frustrada da tonga_smu e a falha de estresse do systemd-udevd é uma prova fantástica para a engenharia do driver amdgpu.

Não aposenta a 380 ainda não, mano! Seu relato prova 100% que é um problema de software/driver do Kernel Linux e não defeito no seu hardware. Valeu demais por ter postado esse log detalhado! :oncoming_fist::hammer_and_wrench:

Passando para deixar um agradecimento rápido a todos que estão compartilhando os logs e relatos técnicos aqui no tópico!

A análise detalhada dos registros da GPU Tonga (R9 380) e das GPUs Polaris mostrou com clareza a falha na comunicação do driver amdgpu com o microcontrolador de energia no Kernel 6.8+. Isso ajuda demais a provar para a engenharia que não se trata de defeito físico nas placas, mas sim de uma regressão de software que precisa de correção.

Para quem utiliza placas dessas famílias e quiser verificar o status do rastreamento ou somar com a sua própria confirmação junto aos mantenedores da Canonical, o passo a passo e as orientações estão centralizados na primeira postagem deste tópico (Post #1).

Seguimos acompanhando os testes de bancada. Valeu demais pelo fortalecimento da comunidade! :hammer_and_wrench::rocket:

Cara, pode anexar sim. Eu consegui ajeitar a performance no Mint 21 usando o Kernel 6.8, é a única distro que funciona sem dar problemas nesse kernel. Está 7 dias já rodando bastante estável, vamos ver se vai acontecer o mesmo problema depois de um tempo. Instalei o / em BTRFS e configurei pra realizar snapshots diários, se quebrar de novo dou um rollback.

Show de bola, EntusiastaDeVelharia :speech_balloon: ! Muito obrigado por autorizar. Vou anexar o seu trecho do dmesg e da tonga_smu diretamente ao relatório oficial da Canonical — esses logs de estresse em hardware real são valiosíssimos para a engenharia!
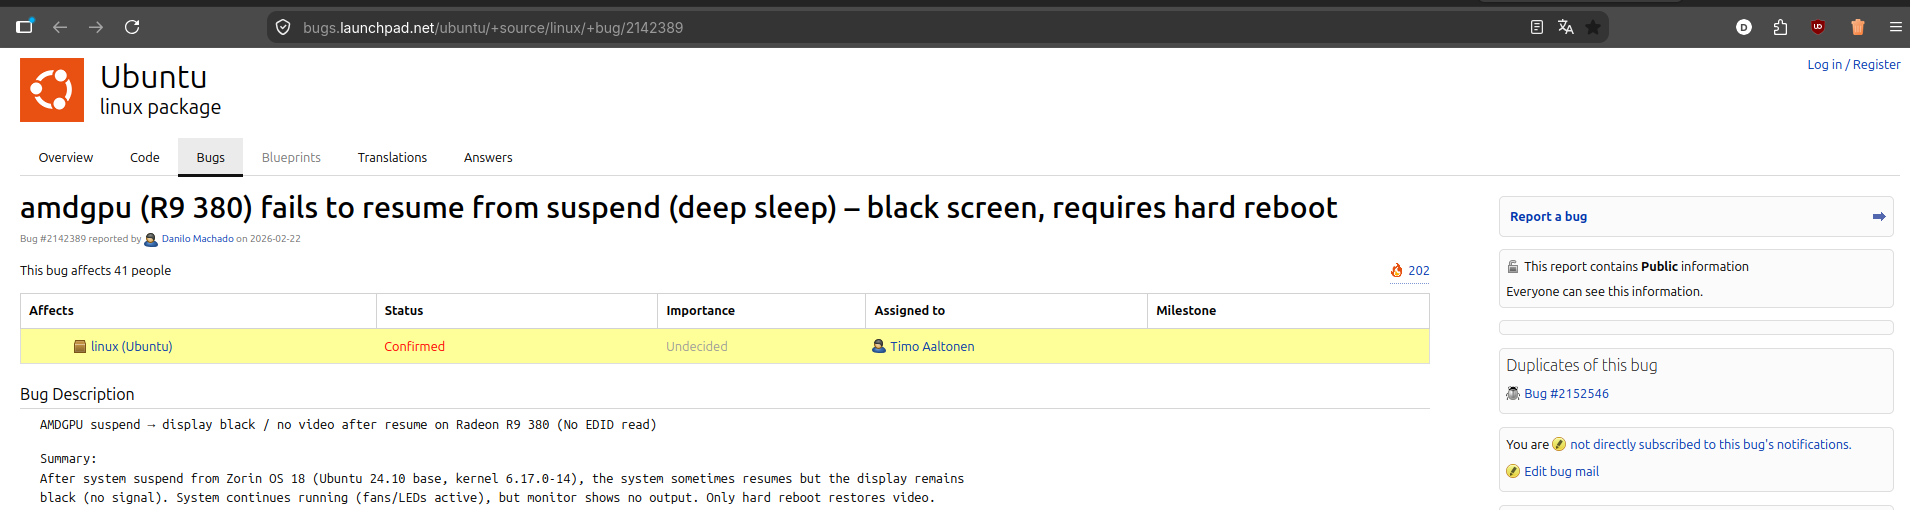
E parabéns pela sacada de usar BTRFS com Snapshots no Linux Mint. Essa é a melhor jogada de proteção para manter o HTPC funcional com o Kernel 6.8 enquanto acompanhamos a estabilidade do driver no seu dia a dia.

Aos demais membros que estão acompanhando o tópico:

Se você também possui alguma GPU dessas famílias (séries R9 300, RX 400, RX 500 ou similares) e quer ajudar a dar a tração que falta para os mantenedores liberarem a correção oficial direto nas atualizações do sistema, as orientações de como registrar a sua placa estão centralizadas no Post #1 deste tópico.

Cada confirmação de uso real conta muito para mostrar aos desenvolvedores a importância de manter esse hardware vivo. Valeu pelo fortalecimento de bancada! :hammer_and_wrench::rocket:

a experiencia pode variar dependendo de quem usa e como usa

Perfeito, Funerea ! Você tocou em um ponto fundamental.

A experiência varia bastante mesmo, e foi justamente analisando essas variações de uso e de ambiente que a comunidade conseguiu isolar o comportamento do bug:

  • X11 vs Wayland: Em vários cenários sob Wayland a imagem retorna, enquanto no X11 o sinal de vídeo cai completamente após o suspend.

  • HDMI vs DisplayPort: Quem utiliza a GPU via DisplayPort raramente enfrenta a falha, pois a regressão afeta diretamente a renegociação do sinal HDMI.

  • Versão do Kernel: Em kernels legados (como o 6.3) o hardware funciona perfeitamente, mas a partir das ramificações do 6.8+ a regressão se manifesta.

É exatamente por causa dessa variação de perfil e de hardware que os relatos de cada usuário são tão valiosos. Quanto mais pessoas compartilham o comportamento em suas distribuições (seja no Mint, Ubuntu, Zorin ou CachyOS), mais dados os desenvolvedores têm para ajustar o driver.

Quem quiser acompanhar os testes ou verificar como registrar o comportamento da sua placa, as orientações continuam centralizadas no Post #1 deste tópico.

Valeu pela contribuição!

É curioso notar como no dia a dia do ecossistema Linux a gente acaba se acostumando a viver de paliativos. Quantas vezes vemos usuários simplesmente desativando o recurso de suspender, travando o Kernel em versões antigas ou recorrendo a comandos no TTY apenas para contornar travamentos, tratando uma falha grave como se fosse algo “normal”?

Muitas GPUs guerreiras da AMD (famílias Tonga e Polaris, como as séries R9 300 e RX 400/500) têm desempenho de sobra para tarefas diárias e jogos, mas acabam perdendo funcionalidade básica por conta dessa regressão no driver amdgpu ao retornar da suspensão.

Em vez de aceitarmos desativar recursos de economia de energia ou nos conformarmos com “quebra-galhos”, o nosso objetivo aqui é buscar a correção definitiva direto na raiz do problema junto aos mantenedores.

Para quem está acompanhando o tópico, utiliza esse hardware e quer somar forças de forma simples e rápida para dar a tração necessária ao relatório oficial, as orientações detalhadas e o caminho para registro estão centralizados no primeiro post deste tópico (Post #1). Experiência com GPUs AMD legadas (Tonga/Polaris) no Kernel 6.8+ e retornos de suspensão

Manter nosso hardware funcional e fora do lixo eletrônico é um ganho para toda a comunidade. Valeu pelo fortalecimento de bancada, pessoal!

Passando para trazer uma atualização muito importante de bancada! :tada:

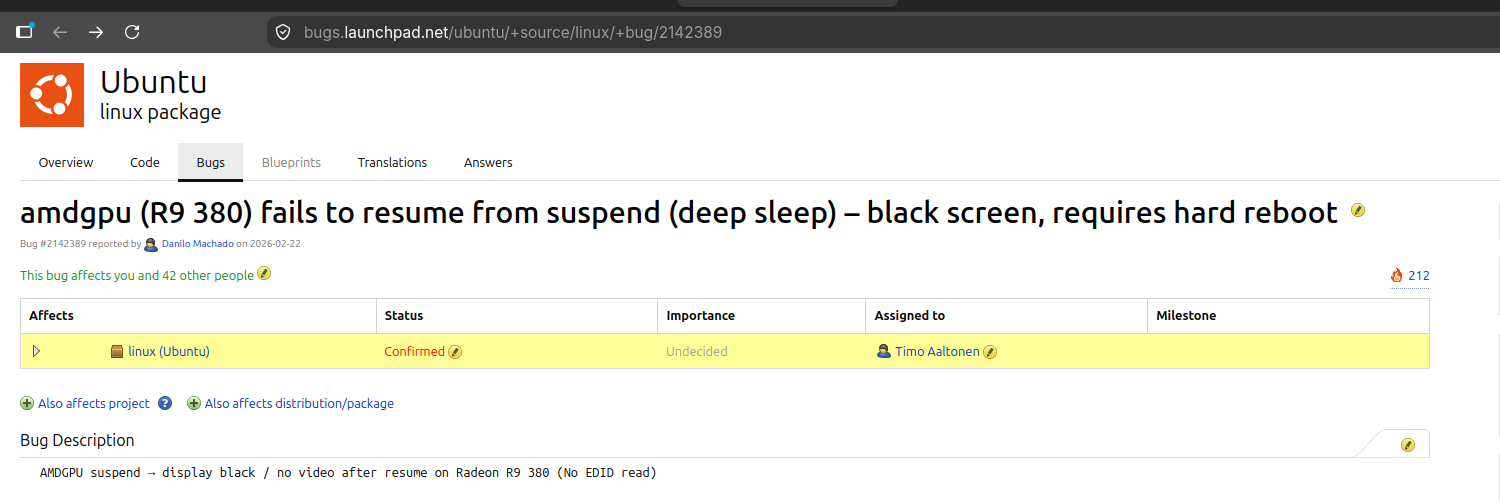
Com o apoio e os relatos compartilhados pela comunidade, ultrapassamos oficialmente a marca dos 200 pontos de relevância (Bug Heat) no Launchpad da Canonical, alcançando a marca de 202 pontos e 41 usuários registrados como afetados por essa regressão nas GPUs AMD!

Atingir essa pontuação é fundamental porque o sistema do Launchpad utiliza o Bug Heat justamente para medir o impacto real da falha no ecossistema e definir a prioridade de atendimento dos desenvolvedores. Cuanto maior essa marca, mais atenção o caso recebe para a liberação de um patch oficial de correção no Kernel do sistema.

Cada confirmação, log enviado e relato compartilhado até aqui foi essencial. Para quem tem placas dessas gerações (famílias Tonga, Polaris e derivadas), ainda não registrou o seu caso e quer somar com essa tração, as orientações de como participar continuam centralizadas no Post #1 deste tópico. Experiência com GPUs AMD legadas (Tonga/Polaris) no Kernel 6.8+ e retornos de suspensão

Valeu demais pelo fortalecimento de todos. Seguimos juntos para manter nosso hardware vivo e funcional no Linux!

Mais uma atualização importante de bancada para reforçar que a regressão nas GPUs AMD Tonga (GCN 3.0) em kernels recentes é um problema sistêmico de driver!

Recebemos o relato do usuário CK, que utiliza um Apple iMac 27" (fim de 2015) equipado com a GPU R9 M395/M395X (Tonga) ligada a um painel interno eDP. O comportamento relatado por ele no sistema foi o seguinte:

  • Kernel 6.8 (Ubuntu 24.04 LTS): Funcionamento 100% estável e sem erros.

  • Kernels 6.17 / 7.0: O sistema congela segundos após abrir qualquer aplicação com aceleração gráfica.

  • Logs do Diagnóstico: Registros de ring timeout, loops no AtomBIOS e travamentos na SMU7 (gerenciamento de energia).

Esse relato é valioso porque o uso do painel interno eDP de um Mac elimina qualquer suspeita de ser um problema exclusivo de cabos HDMI ou placas-mãe desktop. Ele inclusive registrou esses dados diretamente na issue #5680 do GitLab da AMD.

Isso prova que a pilha do driver amdgpu para a arquitetura Tonga precisa de atenção urgente nos kernels mais recentes para evitar que essas máquinas fiquem inutilizáveis.

Para quem quiser conferir o passo a passo de como registrar o comportamento da sua placa no rastreador oficial do Ubuntu, os detalhes continuam centralizados no Post #1 deste tópico

Batemos a marca de 206 pontos de relevância (Bug Heat) e 42 usuários registrados como afetados no relatório do Launchpad!

A relevância continua subindo e, no Launchpad, quanto maior essa pontuação, maior é a prioridade técnica para os mantenedores liberarem o patch oficial de correção direto nas atualizações do sistema. Cada confirmação faz uma diferença gigante para a causa!

Se você usa uma placa AMD dessas famílias (séries R9 200/300, RX 400/500, RX 550) ou quer dar aquela força para manter esse hardware guerreiro funcionando 100% no Linux sem virar lixo eletrônico, veja como é simples somar com a gente:

  1. Vá até o primeiro post deste tópico (Post #1) para acessar o caminho do relatório oficial.
  2. Faça login com sua conta do Ubuntu/Launchpad.
  3. Clique em “Yes, this bug affects me” no topo da página.
  4. Se puder, deixe um comentário rápido registrando as suas configurações (modelo da GPU, distro e versão do kernel).
  5. Clique em “Subscribe” (na barra lateral direita) para acompanhar todas as novidades e ser notificado via e-mail assim que houver atualizações dos desenvolvedores.

Valeu demais pelo fortalecimento de cada um! Seguimos acompanhando os testes e puxando essa fila juntos!

Passando com uma atualização de peso para a nossa comunidade de bancada!

Chegamos oficialmente a 206 pontos de relevância (Bug Heat) e 42 usuários registrados como afetados pelo bug de suspensão nas GPUs AMD no Launchpad!

Isso prova a força da mobilização: o relatório está confirmado e atribuído ao mantenedor Timo Aaltonen. No entanto, quanto mais pessoas registrarem o impacto real em suas máquinas, maior o peso técnico para que o patch oficial seja liberado rapidamente nas atualizações do sistema (Ubuntu, Mint, Zorin, Pop!_OS).

Se você possui uma GPU dessas famílias (R9 200/300, RX 400/500, RX 550) ou quer dar aquela força para manter esse hardware guerreiro longe do lixo eletrônico, veja como ajudar em menos de 1 minuto:

  1. Acesse o primeiro post deste tópico (Post #1) para ir direto ao relatório oficial.

  2. Faça login na sua conta do Launchpad/Ubuntu.

  3. No topo da página, clique em “Yes, this bug affects me”.

  4. Se puder, deixe um comentário breve com seu modelo de GPU, distro e versão do Kernel.

  5. Clique em “Subscribe” na barra lateral para acompanhar os avisos e respostas dos desenvolvedores por e-mail.

Cada voto e comentário conta muito para pressionar pela solução definitiva. Valeu demais pelo apoio de todos!

Também levamos a discussão para o Reddit (r/Ubuntu) para dar mais alcance internacional ao relatório! Quem puder passar lá para dar um UP e fortalecer a visibilidade: Post no Reddit

"Sonho que se sonha só

É só um sonho que se sonha só
Mas sonho que se sonha junto é realidade"

  1. Acesse o primeiro post deste tópico (Post #1) para ir direto ao relatório oficial.
  2. Faça login na sua conta do Launchpad/Ubuntu.
  3. No topo da página, clique em “Yes, this bug affects me”.
  4. Se puder, deixe um comentário breve com seu modelo de GPU, distro e versão do Kernel.
  5. Clique em “Subscribe” na barra lateral para acompanhar os avisos e respostas dos desenvolvedores por e-mail.

Refletindo sobre os testes e relatos que temos acompanhado no fórum e nas comunidades sobre as falhas no driver amdgpu, um ponto recorrente costuma surgir nos comentários: “Eu tenho essa mesma GPU e aqui funciona perfeitamente”.

No ecossistema Linux, o comportamento do hardware é profundamente influenciado por variáveis de ambiente — desde a placa-mãe e versão do firmware BIOS até o servidor de exibição (X11 vs Wayland), tipo de saída (HDMI vs DisplayPort) e perfil de suspensão do sistema. Por isso, o fato de um bug não se manifestar em determinado setup não anula a existência da regressão nem diminui o impacto de quem enfrenta a falha.

Apoiar a correção de um bug de Kernel, mesmo quando nossa máquina pessoal não é afetada, traz benefícios secundários diretos para toda a comunidade:

  • Higiene da Pilha de Drivers (amdgpu): Corrigir uma regressão elimina débitos técnicos no código do Kernel, garantindo que o gerenciamento de energia e os handshakes de vídeo continuem robustos para múltiplas arquiteturas.

  • Redução de Lixo Eletrônico: Mantém hardware funcional com anos de vida útil rodando com estabilidade, evitando descartes precoces ou trocas forçadas por falhas exclusivas de software.

  • Retenção de Usuários na Plataforma: Impede que usuários novatos ou casuais abandonem o Linux e retornem a outros sistemas operacionais por frustração com travamentos no retorno de suspensão.

  • Maturidade e Solidariedade Open Source: Demonstra para os mantenedores que a base de usuários é ativa em reportar e validar regressões, fortalecendo o suporte a longo prazo para o ecossistema.

    Como vocês enxergam essa dinâmica? Concordam que o apoio mútuo no registro de falhas é o que garante a estabilidade do Linux para todos? :speech_balloon: